
三菱UFJインフォメーションテクノロジー株式会社 導入事例
やりたいことを止めない基盤を
どうつくるか。銀行の生成AI活用
を支えるLLM基盤づくり
- 業種金融(銀行・証券・保険・決済)
- 企業規模1,001名以上~5,000名以下
-
導入サービス
システム開発


Summary
金融業界では、高いセキュリティ要件と品質基準を満たしながら、業務の効率化・高度化に向けて生成AI活用が進んでいます。一方で、複数のLLMを選択肢として扱える仕組みを整えるには、クラウド設計から運用時のモデル更新対応まで、前例が少ないなかで判断が必要です。三菱UFJインフォメーションテクノロジー様は、行内向けのAzureベースの生成AI基盤につづく選択肢として、Amazon Bedrockを用いた環境構築を推進しました。今回、検証から業務適用まで「やりたいことを止めない」状態をどうつくったのか、そして想定を超える開発規模のなかで品質と納期をどう両立したのかを伺いました。


銀行システムへのLLM導入。
プロジェクト発足の背景
今回のプロジェクトが発足した背景と、当時の状況について教えていただけますか?
本格的に関わり始めたのは2024年10月から年末年始にかけての時期でした。世間では既にさまざまなLLMが登場していましたが、当行ではAzureベースの生成AIサービス「AI-bow」を行内向けに提供しており、利用できるのはOpenAI社のGPTモデルファミリーに限られていました。
全行的に生成AIを活用して業務の効率化や高度化を図ろうという機運が急速に高まるなかで、ClaudeやGeminiなど他のLLMも選択肢として利用できる環境が求められるようになっていました。一方で、金融機関として求められるセキュリティやガバナンスの要件は当然満たさなければなりません。
当時の課題は、単に新しいLLMを追加することではなく、「今後さらにLLMが増えても対応できるアーキテクチャをどう設計するか」でした。AI-bowという最初の選択肢をつくるむずかしさと、その先で選択肢を10個に広げていくむずかしさはまったく別のものです。ひとつのLLMを利用する仕組みであれば、そのモデルの仕様だけを考えれば済みます。しかし、複数のLLMを前提にすると、モデルごとの仕様の違いやユースケース、非機能要件なども含めて検討しなければなりません。
将来的に当行としてLLMの選択肢を増やしていくためには、どのようなアーキテクチャにすべきか。その検討こそが、このプロジェクトの出発点でした。
お声がけいただいたのもちょうどその頃です。当時は参照できる前例が少ない状態でした。クラウドベンダー各社やパートナー企業の方々にも何度も参加いただきながら、「PoCを止めない」ことを軸に、さまざまな論点を整理していきました。全体のアーキテクチャに関する議論は黒田様がリードされていましたが、私は壁打ち相手として参加しながら、まずは議論の内容を議事録として残したり、比較表に整理したりしながら、次に何を決めるべきかを可視化する役割を担っていました。
特に、LLMやRAGで扱うデータについて、利用者や組織ごとに適切なアクセス制御を実現するためのテナント分離をどう設計するかという点は重要なテーマでした。金融機関として求められる要件を満たしながら、今後の拡張性も確保しなければならないため、ひとつひとつ丁寧に整理しながら進めていきました。
そうやって手探りで検討を重ねた結果、複数のLLMや将来的なエージェント機能にも対応できる取り組みのひとつとして、Amazon Bedrockを活用した基盤構築プロジェクトがスタートしました。構成については、机上で比較するだけでは判断しきれない部分もありました。そのため、実際に自分で環境を構築しながら検証を行い、「この形であれば実現できる」という確信を得たうえで進めています。
そこは私自身も非常に印象に残っています。方針を判断される立場でありながら、ご自身でも手を動かして検証されたうえで議論に臨まれていたので、認識のずれが起きにくかったのです。こちらが提案をお伝えする際も、実際の検証結果を前提に会話ができるため、議論が抽象論になりませんでした。そのおかげで、前例の少ないテーマでありながらも、具体的な判断を積み重ねながらプロジェクトを前に進めることができたと思います。
体制の立ち上げと、開発を進めるなかでの課題
開発体制はどのように立ち上げていったのでしょうか?
AWSサービス上での開発やプラットフォームエンジニアリング、最新の生成AIに関する知見に加えて、当行固有の手続きや品質基準も理解しながら開発を進める必要がありました。複数の要素を同時に満たしながら開発を進めるには、それなりに高いスキルが求められると思います。
そのため弊社としては、まずプロジェクトを推進する人選から始めました。当時は個人で生成AIを活用する人はいても、業務として開発経験のあるメンバーはまだまだ多くありませんでした。そこで重視したのは、金融業務の知識そのものよりも、技術への関心が高く、新しい領域でも自分で調べて追いつけることです。御社固有の手続きや品質基準は参画後に習得する前提で考え、宮城を推薦させていただきました。
金融機関特有の知識やプロセスについては、どのようにキャッチアップしていったのでしょうか?
当初はむずかしい課題も多く、打ち合わせの内容についていくのも簡単ではありませんでした。ただ、単なる技術提供者ではなく、組織の一員になったつもりで業務やプロセスを理解しようと努めました。わからない用語や業務知識があればその都度調べながら理解を深め、できるだけ早く同じ言葉で議論できる状態を目指していました。
私はAI-bowの開発チームに所属しており、面白そうなプロジェクトがあると聞き、途中から参画しました。正直に申し上げて、みなさんのキャッチアップ力には驚かされました。元々の技術力の高さは理解していましたが、当行固有の手続きやシステム仕様、運用上の考え方について、ほぼ知識がない状態から参画されたにも関わらず、短期間でマニュアルを読み込み、必要な知識を吸収されていました。共通言語で議論できる状態になるまでのスピードは非常に速く、強く印象に残っています。
伊東様にそういっていただけると、頑張ってきた甲斐があります。ただ、短期間で同じ言葉で話せるようになったのは、伊東様が行内の制約と技術の両方を理解されていて、こちらの疑問に的確に答えてくださったおかげだと思っています。
開発は、どのように分担して進めたのでしょうか?
私自身は、Amazon BedrockのRAG基盤であるナレッジベース機能を扱う部分の開発を中心に担当しました。単純にモデルを呼び出すチャット機能とは異なり、データの取り込みや保持の仕組みが加わるため構成も複雑になります。また、テナント分離をどのように実現するかという重要な論点も、この領域に集約されていました。前例の少ない開発だったこともあり、実装だけでなく、単体テストの観点やコードの記述基準についても整理しながら進めていました。
あの領域は、今回の開発のなかで特に負荷と難易度が高かった部分だったと思います。加えて、伊東様がテスト観点やコードの基準まであらかじめ整理してくださっていたので、私たちも同じ基準に沿って開発を進めることができました。おかげでチーム全体として品質基準をそろえながら進めることができたと思います。
ベンダーという立場を越えた
プロダクト視点での支援
プロジェクトを進めるなかで、特に印象に残っていることはありますか?
印象的だったのは、「任された範囲だけを対応する」という姿勢ではなかったことです。今回の開発は、AWSや生成AIの技術だけでなく、当行固有の手続きや業務部門との調整も必要なプロジェクトでした。そうした中でSHIFTのみなさんは、開発支援という枠を超えて、「このプロダクトを成功させるためには何が必要か」という視点で動いてくれていたと感じています。業務部門との調整や仕様の整理についても主体的に関わってくださり、課題に対する解決策を自ら考えて提案してくれることが多くありました。そうした姿勢は非常に頼もしかったですね。
業務部門のみなさまからいただくご要望をもとに、何を実現したいのかを一緒に整理しながら要件へ落とし込んでいきました。その際は開発側の視点だけでなく、この基盤が利用者にとって本当に使いやすいものになっているか、行内のセキュリティ基準を満たす運用になっているか、といった点まで踏み込んで提案させていただきました。
開発が進むにつれて、新たな課題はありましたか?
はい。開発を進めていくなかで、テストで担保すべき範囲が当初の想定よりも広いことがわかってきました。その結果、テストフェーズで当初の計画を超過する見込みが出てきました。一方で、リリース時期は変えられません。そのため、品質と納期を両立させるための体制の見直しが急務となりました。
結合テストに入る段階で、まずテスト計画を引き直しました。どのテストをどの順番で実施し、それぞれにどれだけの工数がかかるのかを整理してスケジュールに落としてみると、当時の体制では期間内に終わらないことがはっきりしました。当初想定していた体制が変わったこともあり、結合テスト初期の時点で不足工数を数字でお示ししました。そのうえで、体制の補強が必要だと問題提起させていただきました。その後は御社側で柔軟にご対応いただき、体制を組むことができました。
早い段階で数字を示してもらえたので助かりました。結果として、他のラインからの支援も受けて体制を組み直し、当行の品質基準を満たしたうえで、計画どおりリリースすることができました。
LLM活用の拡大と次世代基盤への展望
初期リリースを終えた現在、プロジェクトはどのようなフェーズを迎えていますか?
現在は本格運用とさらなる拡張のフェーズに入っています。既にいくつかの部署で利用が始まっており、なかでも脆弱性診断のようなホットな領域では新しいモデルの活用を含めて高い関心が寄せられています。一方で、「もっと新しいモデルを使いたい」という要望も増えてきています。当初からの目的は、特定のモデルを使うことではなく、「1を10に広げられるプラットフォーム」をつくることでした。その意味では、複数のLLMを取り込める基盤を整備できたことは大きな成果だと考えています。
私はリリース後の運用・拡張フェーズから参画しました。生成AIの技術進化は非常に速く、数ヶ月前にはむずかしかったことが新しいモデルの登場によって実現できるケースも少なくありません。一方で、モデルを追加する作業はいまも一律ではありません。たとえばAPIのレスポンス構造がモデルごとに異なるため、モデルの追加ごとにログの取得や管理について対応が必要になります。そのため、新しいモデルが公開された際には、依頼を待つのではなく既存モデルとの差分を自発的に検証し、基盤への影響と対応方針をあわせてご提案するようにしています。
今後のシステム拡張や生成AI活用の高度化に向けて、
SHIFTへの期待と、今後のビジョンについてお聞かせください。
最初は限られた打ち合わせのなかで関係性を築くところからのスタートでしたが、いまでは「どうすればもっとよいシステムになるか」と熱く議論できる関係になっていましたね。今回、当行の開発プロセスやシステム特性も理解していただけたので、今後は生成AI関連以外の領域についても、相談先のひとつとして期待しています。
ありがとうございます。題材はAIではありますが、ベースにあるのはシステム開発なので、まずは高い品質でお届けすることが前提だと考えています。そのうえで、御社が次に取り組まれたいことに対して必要な体制をしっかり準備していきたいと思っています。
現場としては、御社がやりたいと思われたことを止めずに、できるだけ早く形にすることを今以上にやっていきたいと思います。技術の選択肢がこれだけ速く増えていく領域ですので、新しくやってみたいことが出てきたときに、そのつど一緒に検討できる相手でありつづけたいと考えています。
技術に精通された方々とひとつのものをつくらせていただける環境で、非常にやりがいがあります。私も日々アンテナを張り、自発的な提案を行ってご期待に応えられるよう取り組んでいきたいと思います。
今後も新しいモデルやAIエージェントのような技術が次々と登場してくると思います。その変化を受け止めながら、銀行業務で安全かつ継続的に活用できる基盤を育てていくことが私たちの役割です。そのためには、業務ニーズと技術の進化の両方に向き合ってくれるパートナーが欠かせません。今回、SHIFTさんには当行のシステム特性や開発プロセスを深く理解していただきました。今後もさまざまなプロジェクトが控えていますが、どのような課題にも一緒に向き合いながら、行内の生成AI活用を支える基盤を育てていけることを期待しています。
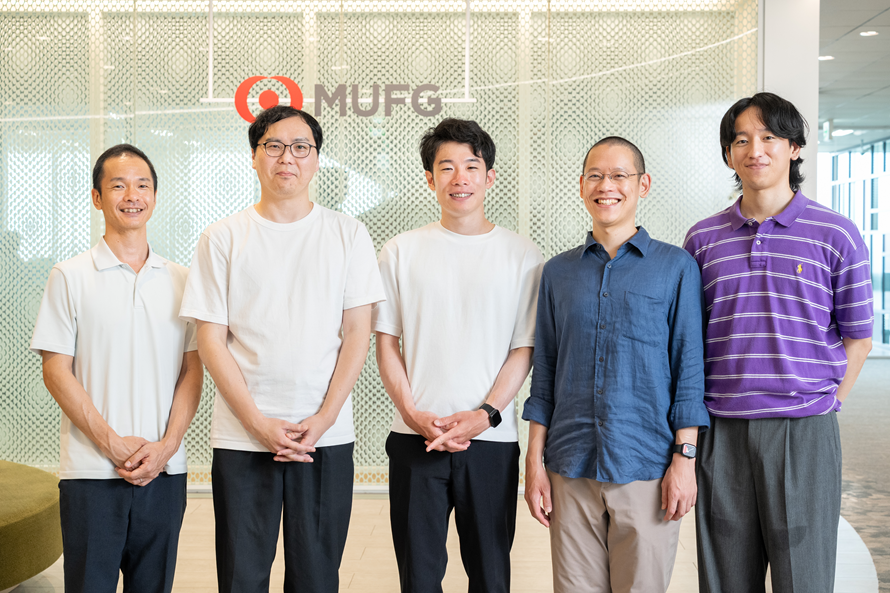
※掲載内容は2026年7月取材時のものです。
三菱UFJインフォメーションテクノロジー株式会社
同業種の導入事例
-
- AIソリューション
事務のミス削減と業務効率化を両立。現場に寄り添い、運用まで見据え、RPA導入がもたらした現場変革
株式会社セブン・カードサービス

- 業種
- 金融(銀行・証券・保険・決済)
- 企業規模
- 500名以下
詳しく見る
-
- AIソリューション
急成長スタートアップを襲ったIT人材不足の壁。事業を共に推進するパートナーとして、PMOにて支援を継続中。
HiJoJo Partners株式会社様

- 業種
- 金融(銀行・証券・保険・決済)
- 企業規模
- 500名以下
詳しく見る
-
- AIソリューション
システム障害が許されない金融システムにおいて、品質向上を追求していくために欠かせない存在です
三菱UFJトラストシステム株式会社様
- 業種
- 金融(銀行・証券・保険・決済)
- 企業規模
- 501~1,000名以下
詳しく見る
お役立ち資料
テスト計画書のテンプレートやベンダーの比較チェックシートや技術的な講座の動画など今日から使える情報が満載。
-

- AIソリューション
- DX
AI・DX推進の前に押さえるべきBPRの考え方と実践ステップ
AIやDXへの投資を進めているにもかかわらず、期待した成果が得られない企業は少なくありません。その原因は、業務プロセスにある可能性があります。本資料では、AI活用の効果を妨げる業務プロセス診断で現状をチェックしながら、AI活用の効果を最大化するために必要なBPRの考え方と進め方について解説します。
 今すぐダウンロード
-
- AIソリューション
AIは『相談相手』から『働くパートナー』へ
【基礎からわかる】「AIエージェント」の基本と活用事例AI活用が進む中、「毎回指示出しするのが大変」「結局手作業が残る」「もっと成果につなげたい」といった課題や期待をお持ちではないでしょうか?本資料では、AIエージェントの基本的な仕組みや種類をはじめ、導入メリット、企業での活用事例、導入時に押さえるべき課題について解説します。AIを“相談相手”から“働くパートナー”へ進化させるためのヒントをご紹介します。
今すぐダウンロード
-
- AIソリューション
AI駆動開発とは?メリットやリスク、活用イメージを解説
生成AIや機械学習モデルをソフトウェア開発ライフサイクル(SDLC)の全工程に組み込み、AIの支援や自律的な処理を主軸に据えて開発を進めるAI駆動開発に関する資料です。
今すぐダウンロード
-
- AIソリューション
生成AIオペレーション品質向上サービス
生成AIを「導入すること」から「業務に定着させ、継続的に価値を生み出すこと」へとフェーズを進めるためには、データ整備、業務整理、品質評価、改善を一体的に進める専門的な支援が強く求められています。本資料では、生成AI活用に必要なデータ・業務の標準化から組織定着までを幅広く支援する生成AIオペレーション品質向上サービスをご紹介します。
今すぐダウンロード
-
- AIソリューション
- DX
天才くん
生成AIを「誰でも使えること」「業務に直結すること」「安全に使えること」という条件を同時に満たすノープロンプト生成AIツール天才くんをご紹介します。
今すぐダウンロード
-
- AIソリューション
- その他
AI駆動型業務代行支援 AI BPaaS
それはツール提供や派遣業務ではない。SHIFTが「成果が出る」まで伴走する、AIとプロ人材による、まったく新しいBPO。AI駆動型業務代行支援 AI BPaaSについての紹介資料です。
今すぐダウンロード
-
- AIソリューション
所属企業における生成AIに関する意識調査
本調査は、ITエンジニアが生成AIによる生産性向上をどの程度実感しているのか、さらに勤務先での導入状況と、それに対する意識を明らかにしたものです。 生成AI導入の意思決定や推進施策の検討に客観的な判断材料として活用いただけることを目指し、本調査を実施しました。
今すぐダウンロード
-
- AIソリューション
- DX
社内ドキュメントAI検索
社内情報・問い合わせ先の検索を一元化して効率化に貢献する、「社内ドキュメントAI検索」についてご紹介します。
今すぐダウンロード
-
- AIソリューション
生成AIの実装と喝采。
GENERATIVE AI REPORT 2025 Autumn生成AIの実装と喝采。 効率化への手応えと、依然として残る不安や課題。 245名の回答からは、生成 AI 利活用をめぐる 現場の躍動と揺れる期待感が浮き彫りとなった。
今すぐダウンロード
-
- AIソリューション
- カスタマーサクセス
AI BPO(業務改善・効率化)サービスご紹介
AIやITをフル活用しながら、単なる作業代替に留まらない包括的な業務改善をワンストップで実現するAI BPOサービスについてのご紹介です。
今すぐダウンロード


